Prometheus и Grafana: как устроен мониторинг серверов
Разбираем связку Prometheus и Grafana: сбор метрик, exporters, labels, PromQL, дашборды, оповещения, защита интерфейсов и первая проверка.
Содержание
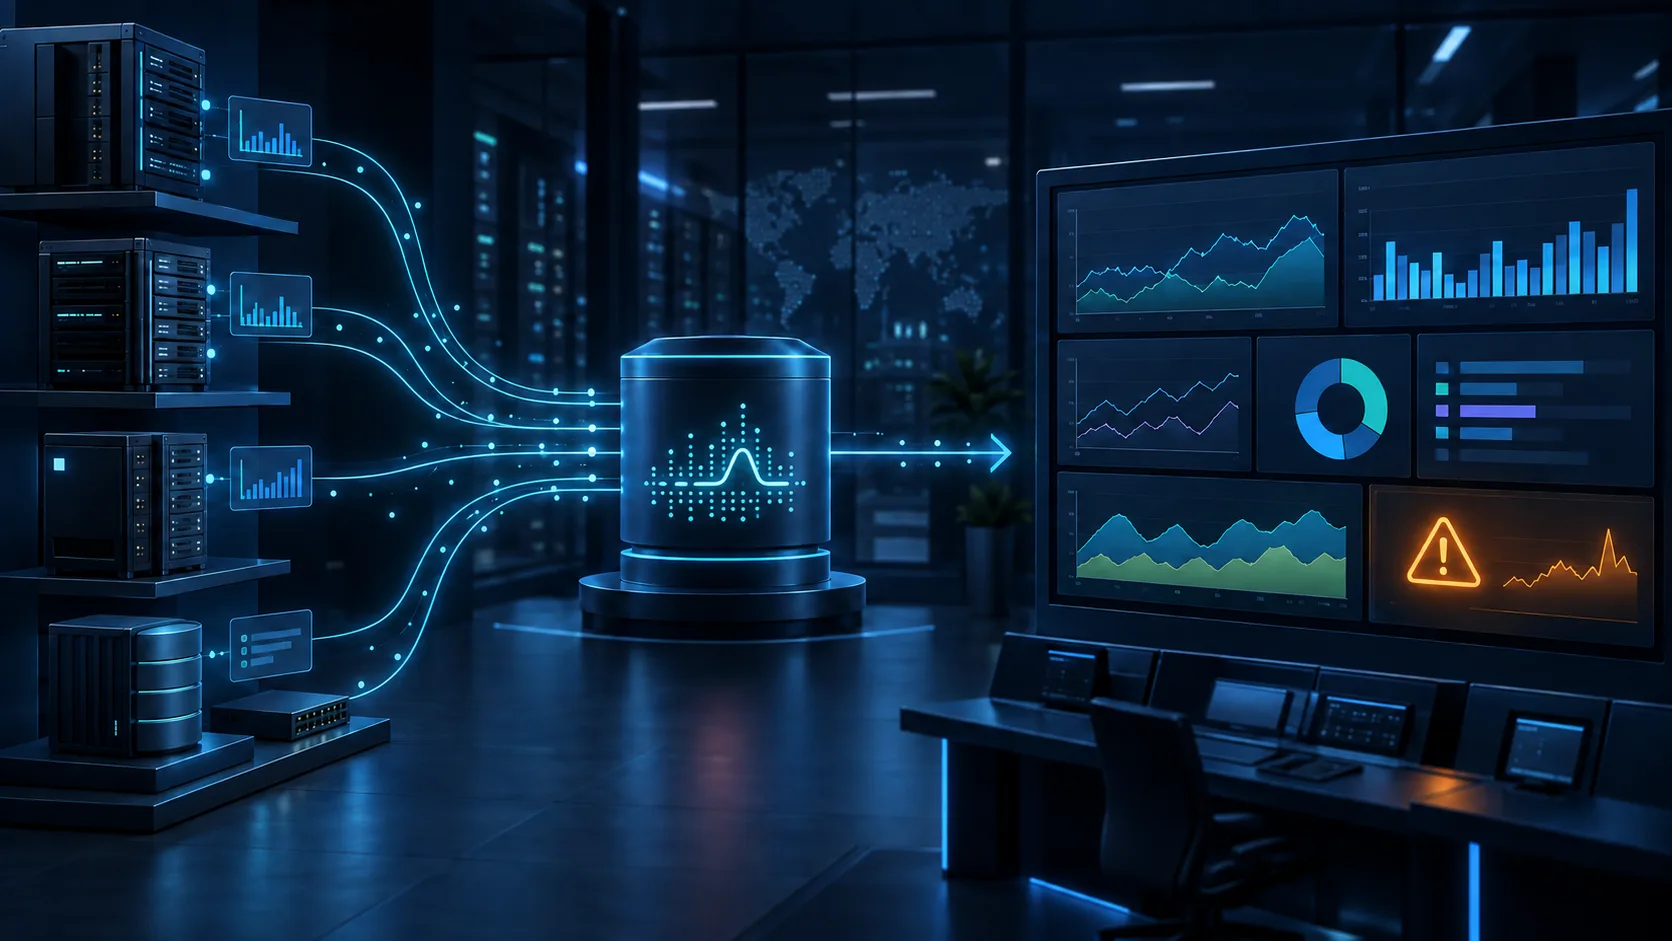
Prometheus собирает числовые показатели систем и хранит их с отметками времени. Grafana запрашивает эти данные и превращает их в графики, таблицы и панели. Вместе они помогают увидеть не только текущее состояние сервера, но и изменение нагрузки за часы или недели.
Эта связка не «следит за всем» сразу после установки. Нужно выбрать источники метрик, задать цели опроса, построить полезные запросы и определить условия оповещения. Начинать стоит с небольшого набора показателей, связанных с реальными отказами: доступность, ошибки, задержка, заполнение диска, память и нагрузка процессора.
Кто за что отвечает
В базовой схеме участвуют четыре части:
- приложение или exporter публикует метрики по HTTP;
- Prometheus регулярно обращается к указанному адресу и сохраняет значения;
- Grafana подключается к Prometheus как к источнику данных;
- правила оповещения отправляют сигнал, когда условие остаётся нарушенным.
Exporter — отдельная программа, которая читает показатели другой системы и представляет их в формате Prometheus. Например, node exporter сообщает о процессоре, памяти, дисках и сети Linux-машины. У самого приложения может быть встроенный адрес /metrics, тогда отдельный exporter для него не нужен.
Prometheus преимущественно использует модель pull: сам опрашивает известные цели через заданный интервал. В интерфейсе можно увидеть, когда цель опрашивалась и успешно ли она ответила. Это важно: отсутствие новых данных отличается от нормального нулевого значения.
Grafana не переносит метрики в свои панели. Панель хранит запрос и способ отображения, а значения получает из источника при открытии или обновлении. Поэтому резервная копия дашборда не заменяет сохранность данных Prometheus.
Что такое временной ряд и label
Метрика состоит из имени, числового значения и набора меток. Метки, или labels, описывают вариант показателя. Условная метрика HTTP-запросов может различаться по методу и коду ответа:
http_requests_total{method="GET",status="200"} 1842
http_requests_total{method="GET",status="500"} 7
Каждое уникальное сочетание имени и labels образует отдельный временной ряд. Prometheus сохраняет его значения во времени. Поэтому label status с несколькими ожидаемыми кодами полезен, а label с идентификатором каждого пользователя или полным URL запроса способен породить огромное число рядов.
Такой рост называют высокой кардинальностью. Он увеличивает расход памяти, диска и стоимость запросов. Идентификаторы запросов, произвольные сообщения ошибок и адреса электронной почты относятся к журналам или трассировкам, а не к labels метрик.
Четыре основных типа метрик
Выбор типа подсказывает, как интерпретировать значение.
Counter — счётчик, который растёт и сбрасывается только при перезапуске процесса. Примеры: количество запросов, ошибок, обработанных заданий. Для графика обычно считают скорость роста, а не показывают абсолютное число.
Gauge — показатель, который может увеличиваться и уменьшаться: температура, размер очереди, занятая память, число активных соединений.
Histogram — наблюдения, распределённые по диапазонам. Он помогает оценивать длительность запросов и строить квантили на стороне сервера Prometheus. Границы диапазонов выбирают с учётом допустимой задержки.
Summary также описывает распределение наблюдений и может вычислять квантили в клиенте. Его агрегация между несколькими экземплярами имеет ограничения, поэтому тип выбирают не по названию панели, а по нужному запросу.
Не называйте метрику requests, если из имени непонятны единица и смысл. Рекомендации Prometheus предлагают базовую единицу и суффикс: секунды вместо миллисекунд, байты вместо мегабайт, _total для счётчиков.
Как Prometheus находит цель
Ниже показан фрагмент файла prometheus.yml для уже установленного Prometheus и node exporter на той же машине. Он не устанавливает программы и не открывает порты.
scrape_configs:
  - job_name: "linux-node"
    scrape_interval: 15s
    static_configs:
      - targets: ["127.0.0.1:9100"]
job_name даёт группе целей понятное имя. scrape_interval задаёт опрос раз в 15 секунд. В targets указан loopback-адрес node exporter; он доступен только с этой машины, если exporter действительно слушает 127.0.0.1:9100.
Перед изменением конфигурации выясните, какой файл использует запущенный экземпляр, и сохраните его копию. Проверка и команда применения зависят от способа установки: системный пакет, контейнер и оркестратор используют разные пути. Не перезапускайте службу командой из случайного руководства, пока не определили свой способ запуска.
Сам источник можно безопасно проверить на сервере:
curl --fail --silent --show-error http://127.0.0.1:9100/metrics | headКоманда только читает первые строки. При успехе видны комментарии # HELP, # TYPE и метрики. Ошибка соединения означает, что exporter не запущен или слушает другой адрес. Пустой успешный ответ также ненормален: сначала исправьте источник, затем добавляйте его в Prometheus.
После применения конфигурации откройте страницу целей Prometheus через защищённый административный доступ. Состояние UP означает, что последний опрос удался. DOWN требует чтения показанной ошибки: отказ соединения, тайм-аут, неверный путь и ответ с неподходящим кодом исправляются по-разному.
Как из счётчика получить полезный график
Язык запросов Prometheus называется PromQL. Сам по себе счётчик запросов всё время растёт, поэтому для графика частоты используют функцию rate. Условный запрос:
rate(http_requests_total[5m])Он оценивает среднюю скорость роста счётчика за последние пять минут для каждого ряда. Prometheus учитывает сброс счётчика после перезапуска. Единица результата — запросы в секунду, если исходная метрика действительно считает запросы.
Чтобы получить общую частоту по всем экземплярам, ряды суммируют:
sum(rate(http_requests_total[5m]))Не копируйте запрос, пока не проверили имя и labels своей метрики. В Grafana удобно сначала открыть режим Explore, выполнить простой запрос и посмотреть таблицу рядов. После этого задайте понятный заголовок панели, единицу измерения и период. График без единицы и описания нельзя уверенно прочитать во время сбоя.
Какие панели нужны первыми
Большой готовый дашборд выглядит впечатляюще, но десятки неизвестных линий затрудняют работу. Для одного Linux-сервера начните с панелей, которые отвечают на конкретные вопросы:
- доступен ли сервер для Prometheus;
- насколько заняты процессор и память;
- не заканчивается ли место и сколько свободных inode;
- растёт ли дисковая задержка;
- есть ли ошибки сети;
- сколько запросов обслуживает приложение и какова их задержка;
- какова доля ответов с ошибками.
Среднее значение может скрыть короткие пики и один перегруженный экземпляр. Сравнивайте отдельные узлы, смотрите максимумы и выбирайте период, соответствующий характеру проблемы. Для разбора процессов и ресурсов Linux пригодится отдельное руководство.
Оповещение должно требовать действия
Оповещение полезно, если получатель понимает, что проверить. Условие «CPU выше 80% одну минуту» часто шумит при обычной краткой задаче. Лучше связать порог с пользовательским эффектом или исчерпанием ресурса и добавить выдержку времени.
У правила должны быть:
- название наблюдаемой системы;
- условие и длительность нарушения;
- ссылка на график или инструкцию диагностики;
- ответственный канал;
- проверенный маршрут доставки;
- состояние отсутствующих данных.
Prometheus может вычислять правила, а Alertmanager — группировать, подавлять и направлять оповещения. Grafana также имеет собственную систему alerting. Не включайте два независимых одинаковых правила без намерения: дубли быстро приучают игнорировать сообщения.
Закройте административные интерфейсы
Метрики раскрывают имена узлов, версии, пути, адреса и поведение приложения. Административные API могут позволять выполнять запросы, менять панели или настройки. Prometheus прямо предупреждает, что пользователи с доступом к HTTP-интерфейсу получают доступ к временным рядам и служебной информации.
Не публикуйте Prometheus, exporters и Grafana в интернет без необходимости. Разместите их в отдельной сети, ограничьте firewall, используйте HTTPS и аутентификацию через поддерживаемый способ. Смените начальные учётные данные Grafana и выдавайте пользователям минимальные роли. Секреты источников данных храните в настройках, а не в экспортированном JSON дашборда.
Для удалённой команды доступ организуют через корпоративную сеть, защищённый gateway или другой контролируемый канал. Сам факт наличия страницы входа не заменяет сетевого ограничения и обновлений.
Как понять, что мониторинг готов
Проведите короткий контролируемый тест:
- убедитесь, что все ожидаемые цели имеют состояние UP;
- откройте исходную метрику и проверьте её единицу;
- создайте одну панель с понятным запросом;
- временно задайте тестовое условие оповещения;
- подтвердите получение и последующее закрытие сообщения;
- перезапустите тестовый exporter и проверьте, что разрыв данных виден;
- сохраните конфигурацию и дашборды в резервную копию.
Не создавайте реальную нехватку диска или памяти на production ради теста. Для проверки оповещения используйте безопасную тестовую метрику или отдельный стенд. Если сервер уже нестабилен, начните с системных журналов и статьи о journalctl, а мониторинг внедряйте после устранения текущей причины.
Источники
Самопроверка
Проверьте, что материал усвоен
Ответьте на все вопросы. Результат сохранится только в этом браузере и будет учтён в статистике прочитанных материалов.
Разбираем коротко
Частые вопросы
Grafana собирает метрики с серверов сама?
Обычно нет. В этой связке Prometheus опрашивает источники и хранит временные ряды, а Grafana обращается к Prometheus как к источнику данных и строит панели.
Заменяют ли метрики журналы приложений?
Нет. Метрики хорошо показывают изменение числовых показателей, а журналы содержат подробности отдельных событий. Для диагностики их используют вместе.
Можно ли открыть Prometheus и Grafana всему интернету?
Не следует делать это без защиты. Интерфейсы и API раскрывают сведения об инфраструктуре, а административные функции Grafana требуют аутентификации и сетевого ограничения.