Балансировка нагрузки в Nginx: алгоритмы, отказ и безопасная настройка
Подробно о балансировке HTTP-нагрузки: round robin, least connections, веса, сессии, проверки backend, тайм-ауты, повторы запросов и наблюдаемость.
Содержание
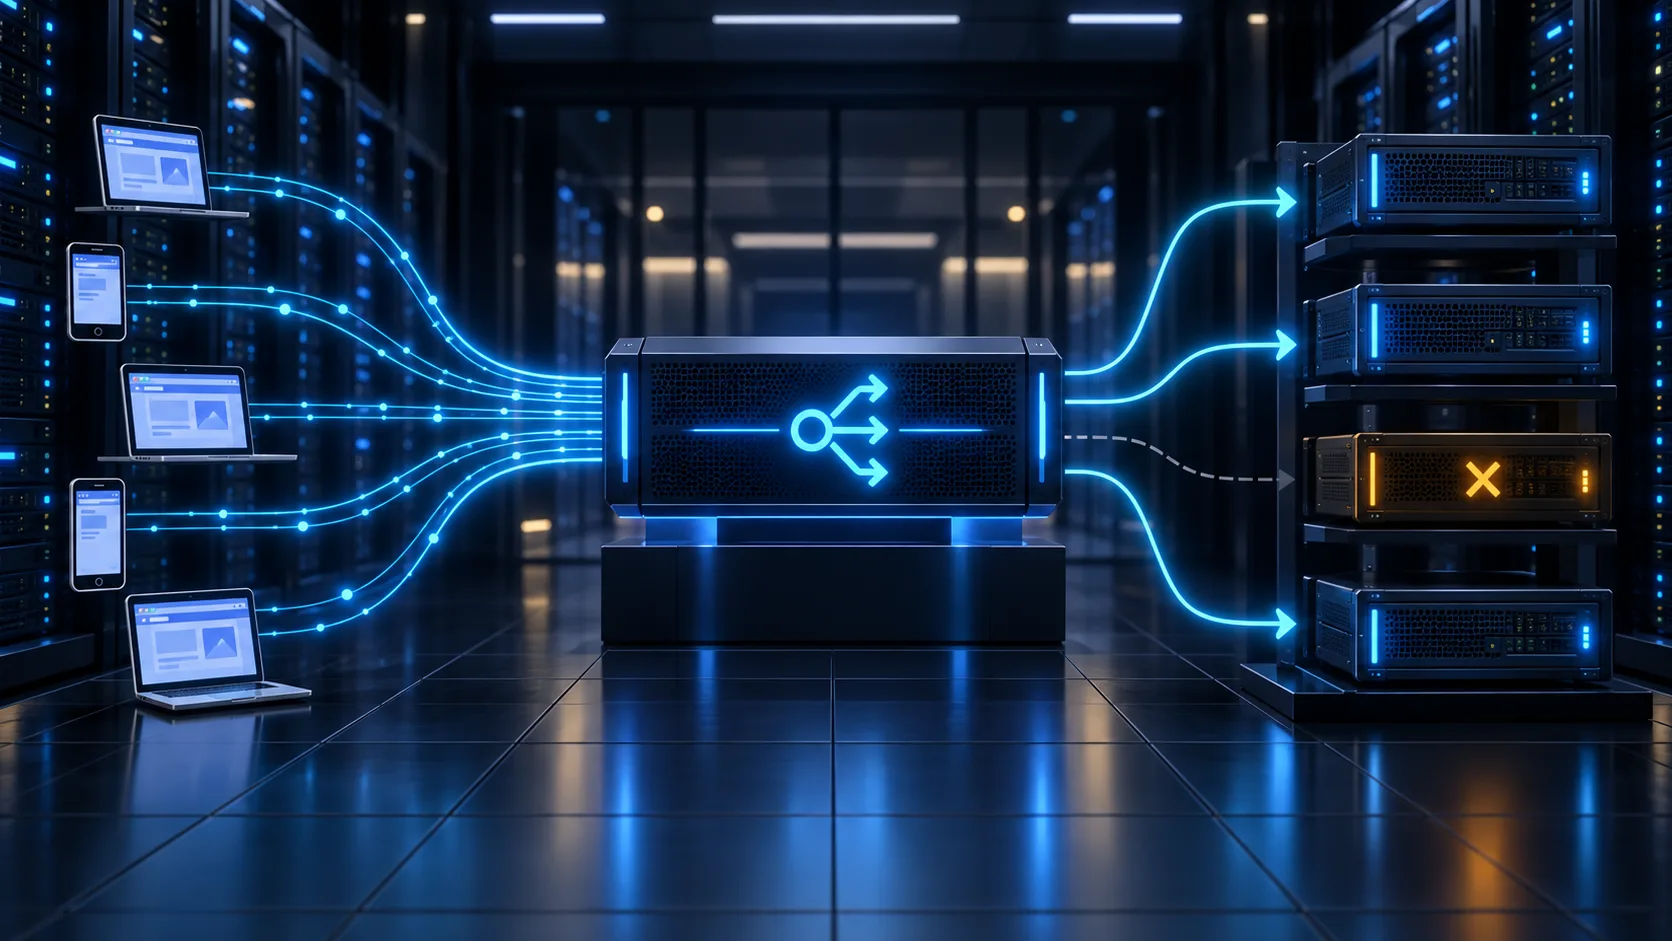
Балансировщик нагрузки принимает запросы по одному адресу и распределяет их между несколькими экземплярами приложения. Он нужен не для того, чтобы «сделать сервер быстрее» одной директивой, а чтобы управлять параллельной ёмкостью, обновлениями и отказами.
Прежде чем добавлять Nginx, ответьте на три вопроса: где хранится пользовательское состояние, как определяется готовность экземпляра и что произойдёт при повторе запроса. Если приложение рассчитывает на локальный файл или память конкретного процесса, равномерное распределение может нарушить его работу.
Место балансировщика в системе
Типовая цепочка: клиент → DNS/CDN → Nginx → экземпляры приложения → база и зависимости. Nginx работает как reverse proxy: завершает внешнее соединение, выбирает backend и открывает к нему отдельное.
Балансировка бывает на разных уровнях. L4 принимает решения по IP, порту и TCP/UDP, не разбирая HTTP. L7 понимает метод, путь и заголовки, поэтому может направить /api/ отдельно от статики. Nginx HTTP upstream — L7-механизм. Различие влияет на TLS, журналирование и маршрутизацию.
Экземпляры должны быть взаимозаменяемыми
Горизонтальное масштабирование добавляет копии одного сервиса. Чтобы любая могла обработать запрос, приложение по возможности делают stateless — не хранящим уникальное состояние пользователя только в памяти процесса.
Сессии переносят в общую базу или Redis, загрузки — в объектное хранилище либо реплицируемую файловую систему, задачи — в очередь. Локальный кэш допустим, если его потеря не меняет корректность.
Даже при двух backend остаются точки отказа: база, очередь, хранилище, DNS, сам Nginx и площадка. Балансировка приложения не делает всю систему высокодоступной.
Алгоритм выбирает backend
Round robin
По умолчанию Nginx циклически перебирает доступные серверы. При одинаковой мощности и похожей длительности запросов это хорошая отправная точка. Вес задаёт относительную долю: weight=3 в среднем даёт примерно втрое больше запросов, чем вес 1, но не обещает точной пропорции на коротком интервале.
Least connections
least_conn выбирает сервер с меньшим числом активных соединений с учётом весов. Он полезен, когда длительность запросов различается. Число соединений не равно стоимости: одна вычислительная операция может быть тяжелее десятка ожидающих сеть.
IP hash и закрепление
ip_hash старается направлять клиента с одним адресом на тот же backend. Это временно помогает с локальными сессиями, но создаёт перекос: множество пользователей приходит через общий NAT, а изменение состава upstream меняет распределение.
Sticky session не заменяет вынос состояния. Она усложняет обслуживание и восстановление. WebSocket естественно остаётся на выбранном backend до закрытия соединения, но после переподключения может попасть на другой.
Рабочий пример конфигурации
Пример рассчитан на два HTTP-приложения в закрытой сети на порту 8080. Файл разместите в /etc/nginx/conf.d/app.conf или принятой в дистрибутиве структуре. Адреса замените на реальные; не открывайте backend-порты в Интернет без необходимости.
upstream app_backend {
    least_conn;
    server 10.10.0.11:8080 weight=2 max_fails=3 fail_timeout=10s;
    server 10.10.0.12:8080 weight=2 max_fails=3 fail_timeout=10s;
    keepalive 32;
}

server {
    listen 80;
    server_name app.example.com;

    location / {
        proxy_pass http://app_backend;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_connect_timeout 3s;
        proxy_send_timeout 30s;
        proxy_read_timeout 30s;
    }
}
max_fails и fail_timeout участвуют в пассивной оценке: Nginx видит ошибки реальных запросов и временно исключает сервер. Это не активный опрос здоровья в Nginx Open Source.
keepalive 32 сохраняет до 32 неактивных соединений к upstream на рабочий процесс. Это не предел пользователей. Backend тоже расходует дескрипторы и память.
Заголовки передают исходное имя, протокол и цепочку адресов. Backend должен доверять X-Forwarded-For только от известных proxy, иначе клиент подставит ложный адрес. Подробнее — исходный IP за Nginx.
Применение и откат
Сохраните предыдущую версию файла. Затем на балансировщике последовательно проверьте синтаксис, перечитайте конфигурацию и запросите endpoint готовности через публичный адрес:
sudo nginx -t
sudo systemctl reload nginx
systemctl is-active nginx
curl -fsS -o /dev/null -w '%{http_code}\n' http://app.example.com/health
Ожидаются успешный синтаксис, active и код контракта health endpoint, обычно 200. Curl с -f завершится ошибкой при 4xx/5xx.
Если nginx -t не проходит, reload не выполняйте. Если синтаксис корректен, но приложение недоступно, верните предыдущий файл, снова выполните test и reload. Журналы сохраняйте: причина и время нужны для расследования.
Готовность важнее живого процесса
Проверка /health, всегда возвращающая 200 при живом процессе, замечает лишь падение. Readiness должна отвечать: может ли экземпляр обслужить рабочий запрос?
Слишком поверхностная проверка отправляет трафик в неработающее приложение. Слишком глубокая, например запись во все внешние сервисы каждую секунду, создаёт нагрузку и способна исключить все экземпляры при кратком сбое зависимости.
Разделяйте liveness процесса, readiness к новым запросам и внешнюю synthetic-проверку пользовательского сценария. В Nginx Open Source пассивные проверки реагируют на реальные ошибки; активный контроль организуют внешней системой, оркестратором или иным продуктом.
Тайм-ауты задают границы
proxy_connect_timeout ограничивает установку соединения. proxy_read_timeout — промежуток ожидания данных, а не обязательно полную продолжительность ответа. Большой тайм-аут удерживает соединения и маскирует деградацию; маленький обрывает корректные операции.
Согласуйте бюджеты по цепочке. Иначе приложение продолжит дорогую работу после того, как внешний уровень показал ошибку. Для потоковых ответов и WebSocket требования иные: не копируйте 30 секунд в сервис, законно держащий соединение час. Практика выбора описана в руководстве по тайм-аутам.
Повторы способны повредить данные
Nginx может отправить запрос другому upstream при некоторых ошибках. Для чтения это полезно. Для записи повтор опасен: первый backend мог принять платёж или создать объект, но не успеть ответить.
Идемпотентная операция при повторе приводит к тому же результату. GET задуман безопасным, POST по умолчанию нет. Для критических записей приложение применяет ключ идемпотентности, уникальное ограничение и сохранённый результат первой попытки.
proxy_next_upstream рассматривайте вместе с методами, кодами ошибок и контрактом API. Не включайте повтор всего трафика ради исчезновения 502 на графике.
Плавный вывод экземпляра
При релизе backend перестают считать готовым, ждут активные запросы и только потом останавливают. Последовательность:
- вывести один backend из ротации;
- дождаться соединений;
- обновить;
- проверить напрямую и через балансировщик;
- вернуть в ротацию;
- перейти к следующему.
Если экземпляры используют одну схему базы, миграция должна быть совместима со старой и новой версиями одновременно. Балансировщик не исправляет несовместимость данных.
Наблюдаемость
Собирайте число запросов и соединений, задержку по процентилям, 4xx/5xx по backend, тайм-ауты upstream, очередь приложения, CPU, память и число серверов в ротации.
Передавайте идентификатор запроса приложению, чтобы связать журнал Nginx с backend. Не записывайте токены, пароли и полные персональные параметры.
Здоровая балансировка — не идеально равное число запросов, а соблюдение целевых задержек и ошибок при запасе ресурсов. Перекос нормален из-за весов и разной длительности операций.
Отказ самого балансировщика
Если единственный Nginx недоступен, живые backend не помогут. Вход резервируют управляемым load balancer, двумя экземплярами с перемещаемым адресом или другой схемой. У вариантов разные времена обнаружения и переключения.
Размещайте backend по независимым зонам отказа, если среда позволяет. Проверяйте остановку процесса, потерю узла, недоступность базы и исчерпание соединений: это разные сценарии.
Когда схема преждевременна
Для небольшого приложения один наблюдаемый сервер с резервной копией и отработанным восстановлением может быть надёжнее трёх непонятных узлов. Добавляйте балансировщик при измеренной потребности в ёмкости, обновлении без простоя или изоляции отказа.
Сначала устраните медленные запросы, настройте корректное кэширование и измерьте предел экземпляра. Затем определите требуемую доступность и только после этого выбирайте число backend и алгоритм.
Источники
Самопроверка
Проверьте, что материал усвоен
Ответьте на все вопросы. Результат сохранится только в этом браузере и будет учтён в статистике прочитанных материалов.
Разбираем коротко
Частые вопросы
Делает ли один балансировщик систему отказоустойчивой?
Нет. Один экземпляр балансировщика остаётся точкой отказа. Для высокой доступности нужны резервирование входного уровня, независимое размещение backend и план восстановления зависимостей.
Какой алгоритм Nginx использует по умолчанию?
Для HTTP upstream Nginx по умолчанию распределяет запросы циклически между доступными серверами, то есть использует round robin с учётом заданных весов.
Можно ли автоматически повторять POST после ошибки backend?
Без знания семантики операции это опасно: повтор может создать заказ, платёж или запись второй раз. Для изменяющих запросов нужны идемпотентность на уровне приложения и осознанная политика повторов.